Hasta ahora, impedir que tu web se usara para entrenar modelos de IA obligaba a bloquear uno por uno los rastreadores de cada empresa. Eso va a cambiar: el 30 de octubre, Google, Microsoft y OpenAI anunciaron que respetarán una señal común en robots.txt para decir «no quiero que entrenéis vuestra IA con mi contenido».
Qué se ha anunciado
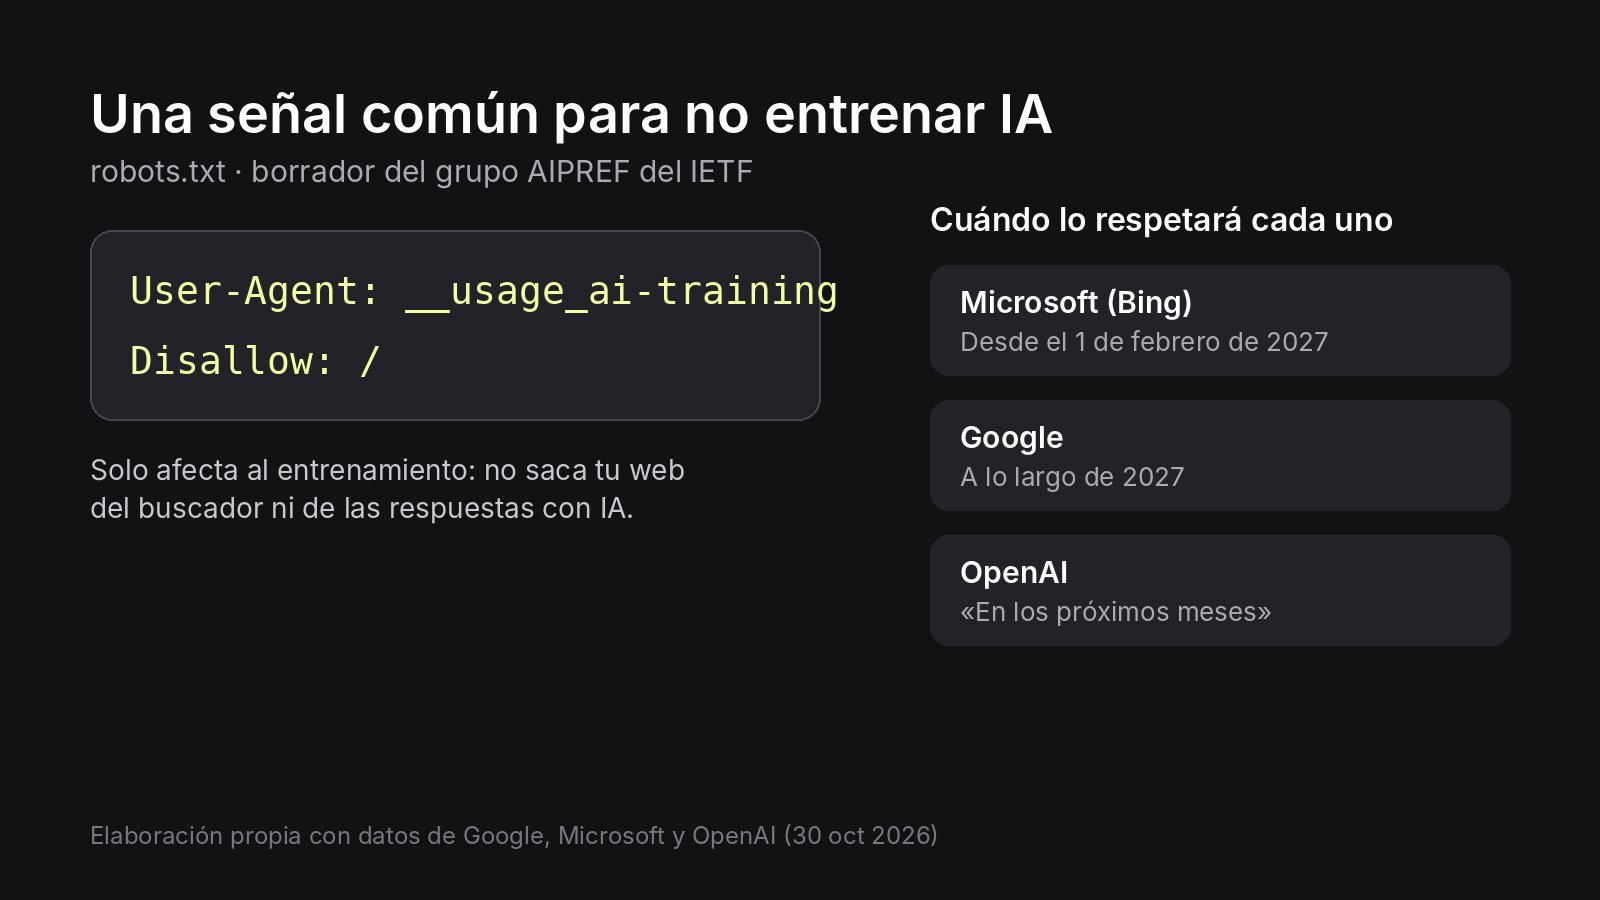
La señal nace de un borrador del grupo de trabajo AIPREF (preferencias de IA) del IETF, el organismo que define muchos estándares de internet. El texto lo firma Kevin Kelley, de Anthropic. En la práctica, basta con añadir dos líneas al robots.txt:
- User-Agent: __usage_ai-training
- Disallow: / (o solo las carpetas que quieras proteger)
Cada empresa tiene su calendario:
- Microsoft rastreará según estas preferencias a partir del 1 de febrero de 2027. Además, separará en dos ajustes el entrenamiento y el uso del contenido para generar respuestas, con cambios en Bing Webmaster Tools desde el 15 de diciembre.
- Google lo aplicará a lo largo de 2027. Si una web usa la nueva señal y no menciona Google-Extended, Google entenderá que también bloquea Google-Extended. Ese control propio seguirá existiendo.
- OpenAI habla de implantarlo «en los próximos meses».
Lo que no hace esta señal
Este matiz es clave: la señal solo afecta al entrenamiento. No saca tu web de los resultados de búsqueda, no impide que te rastreen y no evita que un asistente cite tu contenido en una respuesta. Es una declaración de preferencias, voluntaria, y el IETF todavía no la ha aprobado como estándar.
Qué significa para las marcas
Para un medio o un creador de contenido de pago, la señal es una buena noticia: una sola línea protege su trabajo frente a varias empresas a la vez. Para una marca o una tienda online la decisión es menos evidente. Que los modelos conozcan tus productos, tus precios y tu forma de resolver problemas puede ser justo lo que hace que un asistente te recomiende cuando alguien pregunta qué comprar.
Lo importante es no confundir dos cosas que ahora se separan: el entrenamiento de los modelos y la visibilidad en las respuestas con IA. Bloquear lo primero no tiene por qué afectar a lo segundo, pero conviene decidirlo con datos y no por intuición.
Qué haríamos ahora
- Revisa tu robots.txt actual. Muchas webs bloquean rastreadores de IA por una plantilla o un plugin sin que nadie lo haya decidido.
- Separa el contenido. Fichas de producto, guías de compra y preguntas frecuentes suelen interesar que sean visibles. Informes propios o contenido exclusivo para clientes, quizá no.
- No toques nada todavía por esta señal. Hasta 2027 no la respetará nadie. Mantén los controles actuales y planifica el cambio.
- Trabaja tu presencia en asistentes. Nuestra guía para preparar las fichas de producto para la IA explica cómo hacerlo.
En creatit ayudamos a las marcas a decidir cómo se relacionan con la IA, desde la parte técnica hasta el contenido. Si quieres revisar tu caso, hablemos desde nuestro servicio de Tech e IA.
Fuentes
- Search Engine Roundtable: Google to support AI training control in robots.txt (30 oct 2026)
- ToolNavs: robots.txt gets a shared AI training opt-out
Imagen de portada: elaboración propia con datos de Google, Microsoft y OpenAI.
¿Decidimos juntos qué hacer con tu contenido y la IA?
Revisamos tu robots.txt, tu visibilidad en buscadores con IA y tu estrategia de contenido para que no pierdas tráfico por el camino.